リコーグループ企業・IRサイト

企業に眠る知識を、AIで業務の力に変える。 リコーのAI技術基盤Hi.DEEN
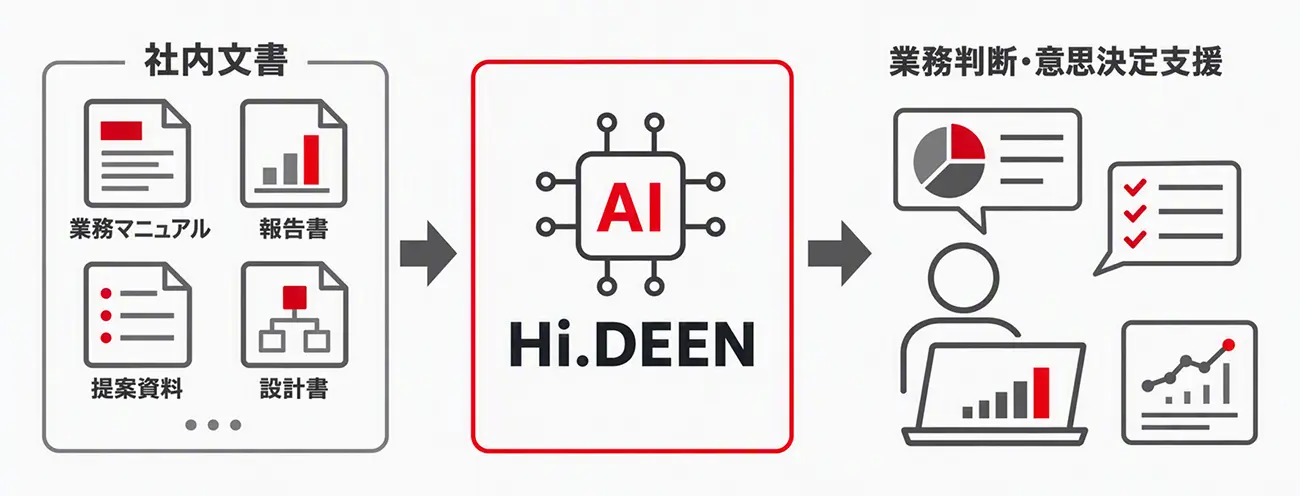
Hi.DEEN(ヒデン)は、企業に蓄積されたドキュメントやデータに含まれる知識を理解・活用し、自律的な判断と業務実行を実現するリコー独自のAI技術基盤です。文書を中心とした企業知識を活かすAI技術により、お客様の業務変革を支援します。
Hi.DEENとは
企業には、業務マニュアルや報告書、提案資料など、日々蓄積される膨大な情報資産があります。しかし、必要な情報がさまざまな場所に散在し、十分に活用されていないケースも少なくありません。さらに、日本では高齢化の進展により、ベテラン社員が長年培ってきた知識やノウハウが失われるリスクが高まっています。こうした知的資産を次世代へ継承し、組織全体で活用していくことが企業の大きな課題となっています。
Hi.DEENの根底にあるのは、AIモデルそのものの性能ではなく、「企業が持つ知識をどう資産として活用するか」という考え方です。単なる文書検索ではなく、複数の文書や図表を横断的に解釈し、企業固有の用語や知識を活かした高度な回答・提案を導き出せる点が特徴です。
お客様の課題
熟練した社員は、社内マニュアルや過去資料などの情報を組み合わせて判断しているが、その活用方法や判断の根拠が組織全体で十分に共有されていない
1つの質問に対して、生産・品質・調達など複数部門にまたがる情報をそれぞれ調べ直す必要があり、対応に時間がかかる
機密情報を含む文書や、自社特有の製品名・略語・判断基準をAIに扱わせることに不安がある(一般的なAIでは正しく理解されない)
Hi.DEENが実現すること
熟練した社員が積み重ねてきた"文書化された知識"をAIが理解し、経験の浅いメンバーでも同じ判断材料をもとに業務を進められる状態にする
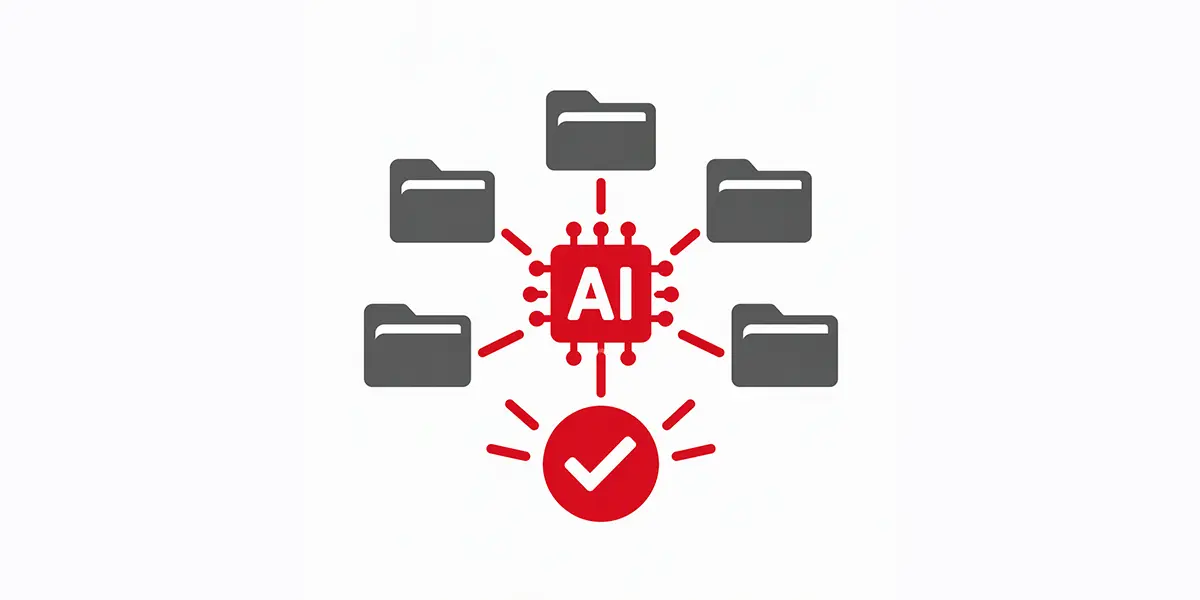
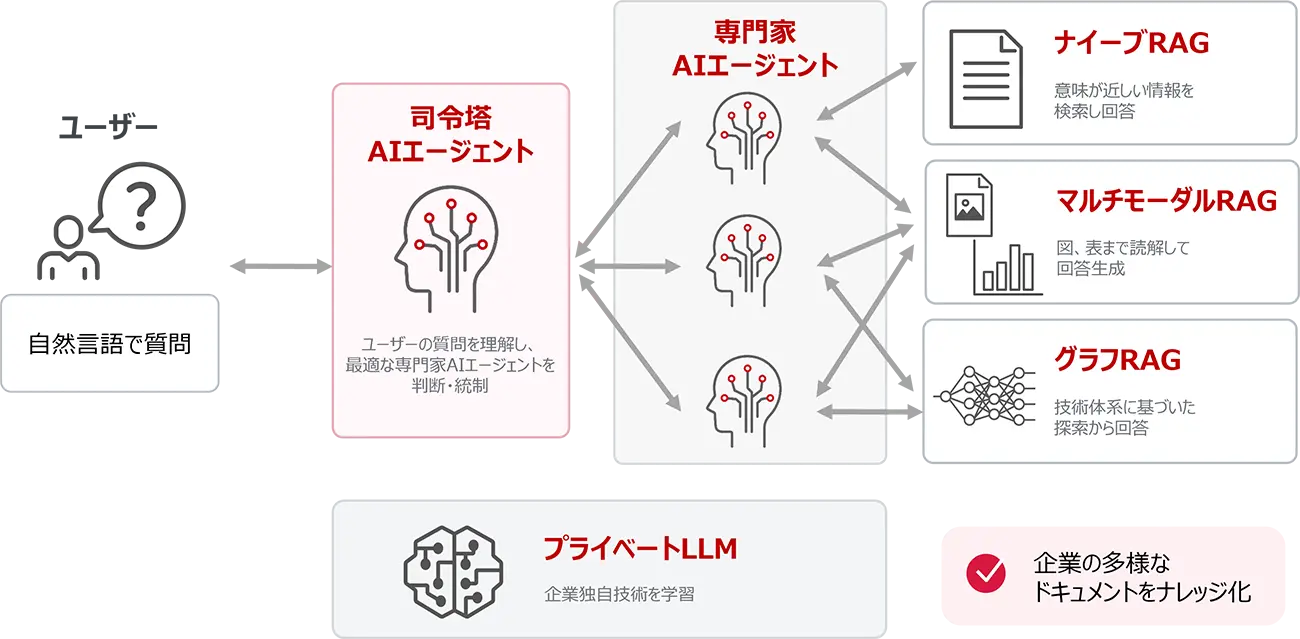
専門家AIエージェントが各部門の視点から情報を検索・整理し、司令塔AIエージェントが統合して、1つの質問から部門横断の網羅的な回答を生成する
オンプレミス/プライベート環境で、企業固有の言葉や判断基準を学習したプライベートLLMにより、セキュアに自社の知識を活用できる
活用シーン
多様な情報を統合的に理解し、幅広い業務を支援します。
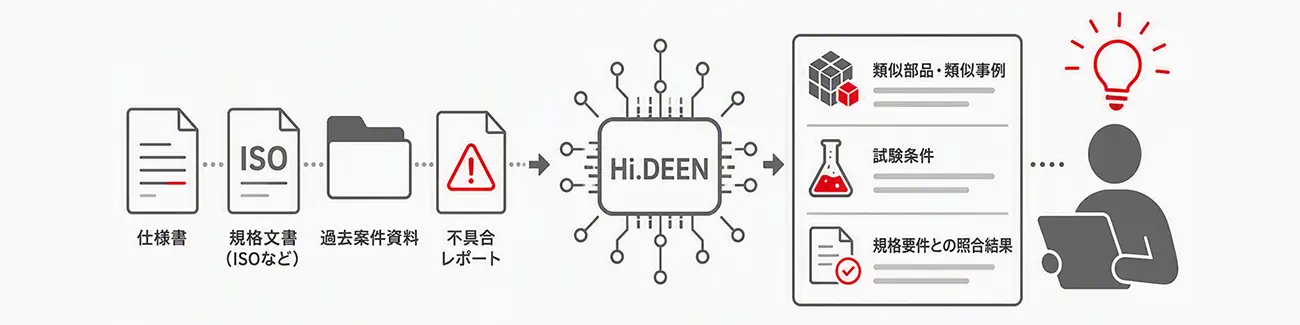
設計・開発 過去案件の資料が点在し、類似事例や不具合対策、試験条件を探すのに時間がかかる。仕様書と規格要件の照合も負担になっている。
複数文書を横断し、設計判断に必要な知見をまとめて提示
過去案件の資料から類似部品・類似事例、不具合対策、試験条件を横断的に検索。仕様書とISO等の規格文書もあわせて解釈し、レビューの効率化と確認漏れの低減を支援します。
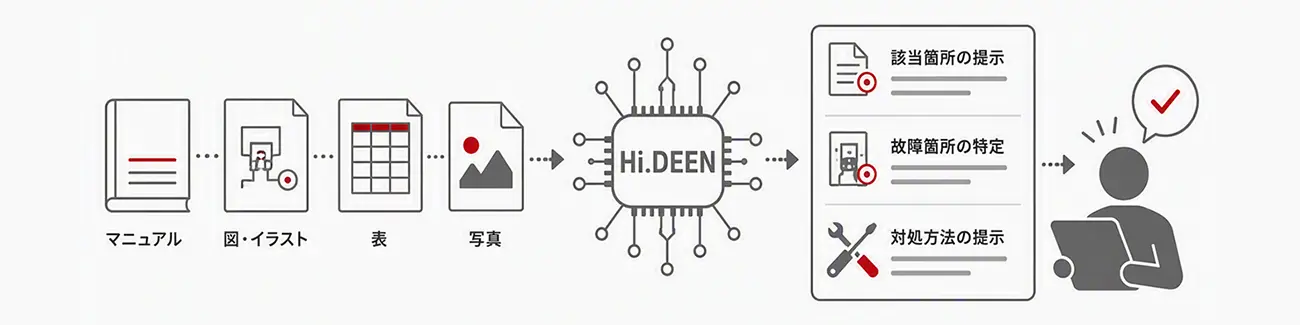
保守・サービス 図や写真を含むマニュアルでは、単純なキーワード検索だけでは故障箇所や対処方法を見つけにくい。
図表・写真と本文を一体で理解し、現場対応に必要な情報を回答
複合的なマニュアルの構成や図表・写真の内容まで読み取り、質問に応じて該当箇所と対処情報を提示。必要な情報への到達を支援します。
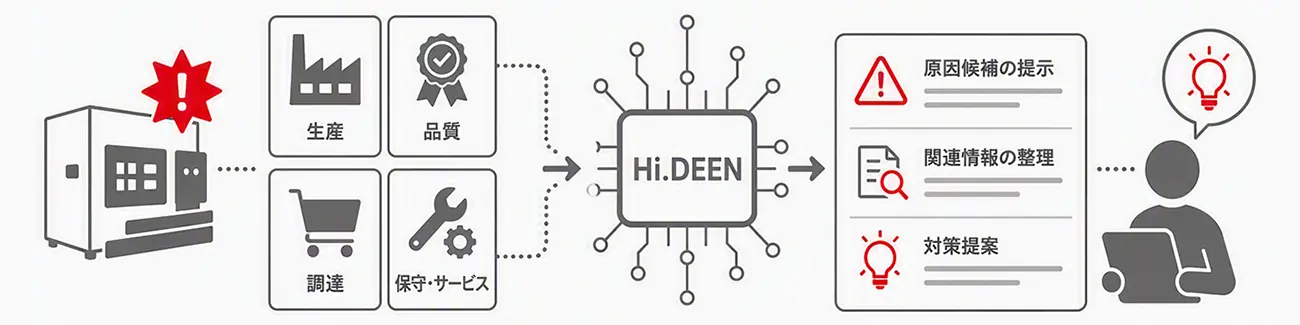
品質管理・トラブル対応 不具合の原因調査で、生産・品質・調達など複数部門の情報を個別に確認する必要があり、全体像の把握に時間がかかる。
専門領域ごとの知見を統合し、部門横断の回答を一度に提示
複数の専門家AIエージェントが各部門の視点から情報を収集・整理し、司令塔AIエージェントが統合。1つの質問から原因候補や関連情報を網羅的に提示します。
Hi.DEENの仕組みと技術
Hi.DEENでは、社内に蓄積された専門知見や業務ナレッジ を直感的かつ横断的・網羅的に検索することができます。
検索対象の企業に特化した知識を持つ「司令塔AIエージェント」がユーザーの質問意図を自然言語から理解し、専門領域ごとの「専門家AIエージェント」へ最適な指示を出すことで、さまざまな企業情報から自律的に最適な回答を導き出します。その技術基盤となるのが、企業独自の知識を学習したプライベートLLMと、目的に応じて使い分けられる複数のRAG(検索拡張生成)技術です。
構成要素
- 司令塔AIエージェント:自然言語によるユーザーの質問の意図を正しく理解し、最適な専門家AIエージェントを判断・統制
- 専門家AIエージェント:専門領域に特化し、RAGや推論機能を選択して回答を生成
- 各種RAG:ナイーブRAG(意味の近さを検索)/マルチモーダルRAG(図表を含む文書を読解)/グラフRAG(知識間の関係性を活用)により、さまざまな企業情報を検索・活用を支える
 RAGとは?社内知識を活用する「検索拡張生成」の仕組みと、進化する企業のAI戦略
- プライベートLLM:導入企業専用のLLM(大規模言語モデル)。企業・業界固有の知識や用語を学習し、複雑な日本語文書・図表を高精度に読み取る独自のマルチモーダル技術を備え、司令塔AIエージェントと専門家AIエージェントの基盤となる“はたらく”を支えるリコーの大規模言語モデル(LLM)
安心して使える仕組み
企業内文書には、設計情報、顧客情報、技術ノウハウ、社内規程など、外部に出せない重要な情報が多く含まれています。Hi.DEENは、こうした企業固有の知識を安全に活用することを前提に、プライベートな環境での利用や、企業ごとの情報管理に配慮した設計を重視しています。
オンプレミス環境やプライベート環境での利用に対応することで、機密性の高い文書や社内ナレッジを扱う業務でも、安心してAI活用を進められる基盤を目指しています。
- 企業内データを外部に出さずに活用する設計
機密情報を含む文書を、社内または管理された環境で扱えるようにします。 - 権限や利用範囲を踏まえた情報活用
利用者の業務や権限に応じて、必要な情報を適切に参照できる仕組みを前提とします。 - プライベートLLMによる企業知識の活用
企業・業界固有の知識や用語を踏まえたAI活用を可能にします。 - 業務利用を前提とした信頼性の向上
回答の根拠となる文書や情報を確認しやすくすることで、業務判断に活用しやすい形を目指します。
主な開発成果
Hi.DEENは、リコーが培ってきた文書理解、生成AI、RAG、AIエージェントなどの技術開発を土台としています。企業内文書を業務に活かすための主な開発成果を紹介します。
2024年企業文書を読み取るマルチモーダルLLMの開発を開始
経済産業省とNEDOによる国内生成AI開発力強化プロジェクトGENIAC*基盤モデル開発第2期に採択。テキストに加えて図や表を含む、複雑な日本語の企業文書を読み取るマルチモーダルLLMの本格開発に着手しました。
-
*GENIAC(Generative AI Accelerator Challenge):経済産業省と国立研究開発法人新エネルギー・産業技術総合開発機構(NEDO)が実施する、国内における生成AIの開発力強化を目的としたプロジェクト
2025年文書理解技術の高度化と業務適用を推進
GENIAC基盤モデル開発第2期の成果となるマルチモーダルLLMの基本モデルを開発。画像処理、OCR、日本語LLMの技術を組み合わせ、段組みや図表、注釈を含む企業文書の内容を理解する技術を強化し、業固有の文書形式や業務に合わせて調整できる設計を進めました。また、マルチモーダルLLMの基本モデルと評価環境を無償公開しました。
GENIAC基盤モデル開発第3期に2期連続で採択され、リーズニング性能を持つマルチモーダルLLM(リーズニングLMM)を開発しました。
2026年複数文書・図表を活用する推論技術と評価基盤を強化
GENIAC基盤モデル開発第3期において、図表を含む多様なドキュメントを高精度に読み取ることができる、リーズニング性能を備えたマルチモーダル大規模言語モデル(以下、リーズニングLMM)の基本モデルを開発し、軽量モデルを無償公開しました。企業文書に対する読解・推論性能を継続的に検証する独自評価基盤「JDocQA Reasoning Benchmark」も公開しました。